Artykuł sponsorowany
Co dzieje się z danymi po sekwencjonowaniu egzomu — od odczytu do raportu
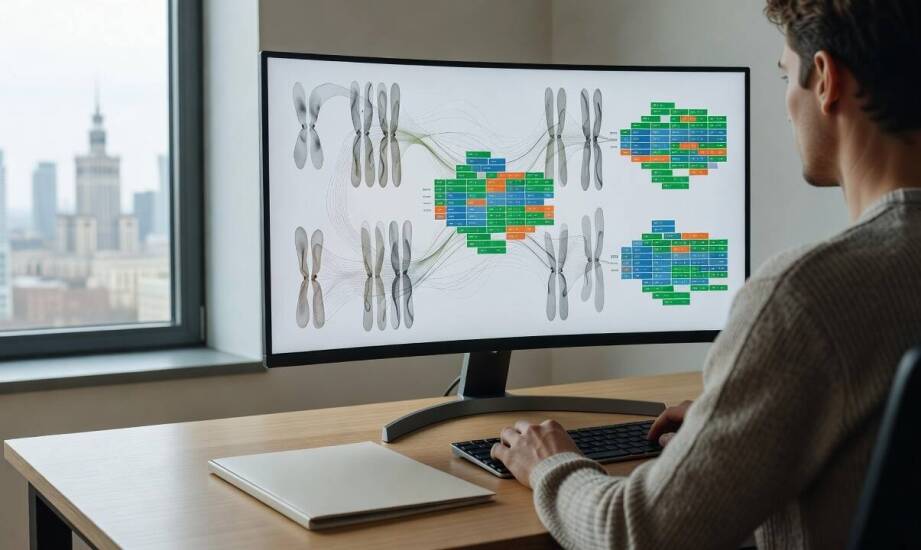
Po pobraniu próbki materiału genetycznego i zakończeniu fizycznego sekwencjonowania egzomu proces diagnostyczny przenosi się do środowiska cyfrowego. Powstają surowe pliki danych, które wymagają wieloetapowego przetwarzania bioinformatycznego. Zamiana milionów pojedynczych odczytów w czytelny raport kliniczny opiera się na wykorzystaniu zaawansowanych algorytmów obliczeniowych. Każdy kolejny krok tej analizy ma na celu stopniowe odrzucenie szumu informacyjnego i wyizolowanie tych nielicznych zmian w DNA, które mogą odpowiadać za diagnozowane objawy.
Przeczytaj również: Jakie są najnowsze osiągnięcia w stomatologii zachowawczej?
Od surowych odczytów do wyselekcjonowanych wariantów
W pierwszej kolejności wygenerowane dane w formacie FASTQ przechodzą rygorystyczną kontrolę jakości. Oprogramowanie odrzuca odczyty o zbyt niskiej wiarygodności oraz przycina sekwencje techniczne, określane jako adaptery. Następnie system mapuje przefiltrowane fragmenty do referencyjnego genomu ludzkiego. Krok ten pozwala precyzyjnie umiejscowić każdy odcinek DNA w odpowiednim miejscu na chromosomie, tworząc pliki BAM.
Przeczytaj również: Innowacyjne technologie w produkcji pieluch dla dorosłych – co warto wiedzieć?
Kolejne etapy skupiają się na poprawie jakości zmapowanego materiału. Algorytmy usuwają duplikaty odczytów i przeprowadzają ponowną kalibrację jakości baz. Historycznie stosowano na tym etapie osobną korektę ułożenia wokół miejsc insercji i delecji. We współczesnych systemach, takich jak najnowsze wersje pakietu GATK, narzędzia wywołujące warianty wykonują lokalne składanie haplotypów bezpośrednio w zidentyfikowanych obszarach, co zauważalnie zwiększa precyzję detekcji bez konieczności stosowania wcześniejszych, przestarzałych procedur.
Przeczytaj również: Jakie pytania warto zadać stomatologowi przed rozpoczęciem leczenia estetycznego?
Wynikiem tego złożonego procesu jest plik VCF, który zawiera wykaz wszystkich różnic między kwasem nukleinowym pacjenta a genomem referencyjnym. Pojedynczy pacjent posiada zwykle około 20 000–25 000 wariantów zlokalizowanych w sekwencjach kodujących. Większość z nich to powszechne w populacji, niegroźne polimorfizmy, które nie wpływają na funkcjonowanie organizmu. Filtrowanie bioinformatyczne redukuje tę listę, opierając się na częstotliwości występowania zmiany, jej przewidywanym wpływie na budowę białka oraz opisanym modelu dziedziczenia. Porównanie materiału z próbkami rodziców dodatkowo usprawnia tę selekcję. Dopiero po nałożeniu obrazu klinicznego diagnozowanej osoby na liście pozostaje kilkanaście kandydujących zmian.
Interpretacja kliniczna i wyzwania diagnostyczne
Wyselekcjonowane warianty genetyczne wymagają drobiazgowej oceny pod kątem ich ewentualnego związku z chorobą. Interpretacja, jakiej wymaga prawidłowo przeprowadzone badanie wes, opiera się w głównej mierze na wytycznych amerykańskich towarzystw naukowych ACMG i AMP. Dokument ten kategoryzuje zmiany genetyczne na pięć grup, od wariantów łagodnych po jednoznacznie patogenne. O przypisaniu do konkretnej grupy decydują ustalone kryteria dowodowe, uwzględniające między innymi statystyki populacyjne, matematyczne modele predykcyjne oraz literaturę medyczną.
Zmiany o niepewnym statusie stanowią największe wyzwanie przy formułowaniu ostatecznego wniosku. Taka klasyfikacja, znana jako VUS, oznacza, że dostępne dane nie pozwalają na jednoznaczne potwierdzenie ani wykluczenie chorobotwórczego charakteru wariantu. Decyzja o ewentualnym wdrożeniu leczenia spoczywa na specjaliście klinicznym, który weryfikuje zapisy z raportu w bezpośrednim zestawieniu ze szczegółowym fenotypem pacjenta.
Samo sekwencjonowanie egzomowe ma również naturalne ograniczenia technologiczne. Obejmuje ono wyłącznie sekwencje kodujące, ale nawet w ich obrębie pokrycie bywa niepełne. Problem ten dotyczy szczególnie regionów bogatych w pary guanina-cytozyna (GC) oraz sekwencji wysoce powtarzalnych, gdzie system ma trudności z poprawnym mapowaniem odczytów. Technologia ta ma mniejszą skuteczność w wykrywaniu rozległych delecji czy duplikacji, które wymagają weryfikacji innymi metodami molekularnymi.
Dynamiczny rozwój nauk medycznych sprawia, że wiedza o powiązaniach między modyfikacjami w genach a konkretnymi chorobami poszerza się z każdym miesiącem. Z tego powodu bazy danych genetycznych podlegają ciągłym i systematycznym aktualizacjom. Powrót do analizy surowych plików po upływie czasu pozwala uwzględnić te nowości i nazywany jest reanalizą. Badania naukowe wskazują, że powtórna ocena materiału pozwala na zwiększenie odsetka rozpoznań o około 7–15%. Dzieje się tak głównie za sprawą reklasyfikacji wcześniejszych zmian o nieznanym znaczeniu lub powiązania opisanego wariantu z nowo odkrytym zespołem genetycznym.
Ostateczna jakość procesu diagnostycznego opiera się na wiedzy i wieloetapowej weryfikacji. W praktyce gabinetu AllGene obserwujemy, że poprawna interpretacja kliniczna wymaga zarówno precyzyjnych narzędzi informatycznych, jak i rzetelnej oceny dowodów medycznych. Dopiero prawidłowe sprzężenie tych dwóch obszarów tworzy raport ułatwiający postawienie finalnego rozpoznania.
Kategorie artykułów
Polecane artykuły
Jak odróżnić budżetowy T-shirt damski, który wytrzyma codzienne pranie i noszenie
Codzienne zakupy odzieżowe często wiążą się z dylematem, zwłaszcza gdy przeglądamy podstawowe elementy garderoby. Pozornie identyczne koszulki z krótkim rękawem mogą diametralnie różnić się zachowaniem podczas użytkowania. Dwa modele w zbliżonej, przystępnej cenie często wyglądają na wieszaku lub zd
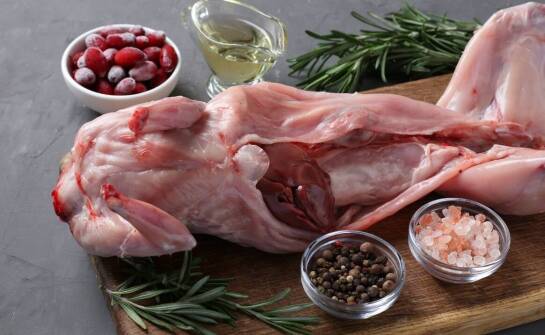
Jak surowe mięso królika wspomaga zdrowie i witalność pupila?
Dieta BARF zyskuje popularność dzięki Super Smakowi, producentowi surowej karmy dla zwierząt, który specjalizuje się w diecie opartej na surowym mięsie, podrobach i kościach. Surowe mięso z królika dostarcza białka oraz niezbędnych składników odżywczych wspierających rozwój i funkcjonowanie organizm